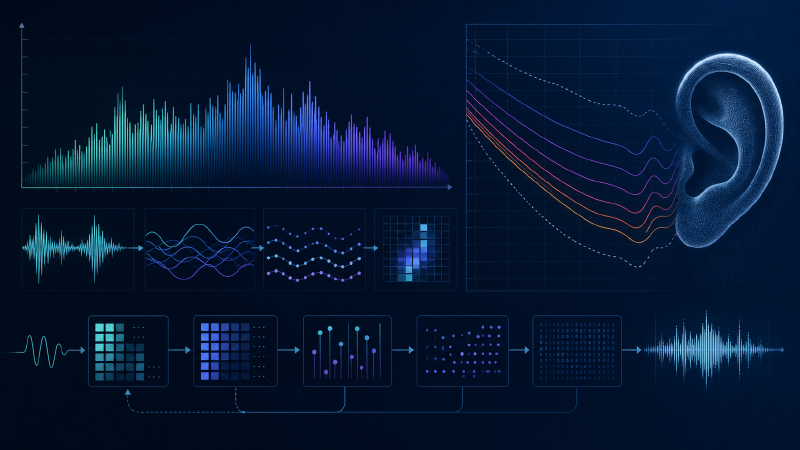
在数字音频讨论里,MP3 常被简单归类为“有损=音质差”。但在高码率(如 320kbps)场景下,很多听众在规范 ABX 测试中并不能稳定区分它和 44.1kHz/16bit 无损源。
这背后的关键不是“MP3 做到了物理无损”,而是它把误差控制在人耳不敏感或被掩蔽的区域。换句话说,MP3 的核心思路不是尽量复制全部波形细节,而是优先保证主观可听质量。
核心前提:心理声学与掩蔽
MP3 依赖两条基本事实:
绝对听阈(ATH) 人耳对不同频率敏感度不同。部分极低频、极高频或很弱的信号,即便客观存在,也可能不可闻。
掩蔽效应(Masking) 当某一频段存在强信号时,邻近频率的弱信号会变得更难被听见。编码器可以利用这点,把量化误差“放”进不易被察觉的区域。
MP3 编码流水线(简化版)
1. 双通路并行
输入 PCM 后,编码器通常并行进行:
- 数据通路:负责把信号变换到适合量化和编码的表示形式。
- 心理声学通路:估计当前帧各频段的可闻阈值,给数据通路提供约束。
2. 子带分析(Polyphase Filter Bank)
先把宽频带信号切成 32 个子带,便于后续分频处理。这一步时间分辨率较好,但频率分辨率仍偏粗。
3. 心理声学分析(常用 FFT 辅助)
编码器通过频谱分析估计:
- 哪些成分是强掩蔽音;
- 各频段可容忍多少噪声;
- 全局掩蔽阈值大致在哪里。
注意:这条通路主要提供“决策依据”,不是直接输出最终编码数据。
4. MDCT 精细频域表示
对子带信号进一步做 MDCT,得到更细粒度的频域系数(长窗常见 576 线,瞬态短窗模式下结构会变化)。
这些系数才是后续量化与码率分配的直接对象。
5. 比特分配与量化:质量和体积的平衡点
编码器需要同时满足两件事:
- 噪声尽量低于掩蔽阈值;
- 总比特数不超过目标码率预算。
一个常见参考量是信掩比:
$$ SMR = E_{signal} - T_{mask} $$其中 $E_{signal}$ 表示信号能量(通常以 dB 度量),$T_{mask}$ 表示该频段掩蔽阈值。
实现上通常是迭代搜索:
- 内层调整局部量化,控制各频段噪声;
- 外层控制全局步长和总比特,保证码率目标。
6. 熵编码(Huffman)
量化后大量系数变小或归零,再进行哈夫曼编码,用更短码字表示高频出现符号,进一步压缩数据体积。该步骤本身是无损的。
7. 比特流封装
将主数据、比例因子、侧信息、帧头等按标准格式打包,形成连续 MP3 帧。
小结
MP3 的工程价值在于:它不是“简单删细节”,而是结合听觉模型做受控失真,让失真尽可能落在人耳不敏感区域。
因此,高码率 MP3 往往能在体积和主观听感之间取得很高的性价比。它不是物理意义上的无损,但在很多实际聆听条件下可以达到接近透明的结果。