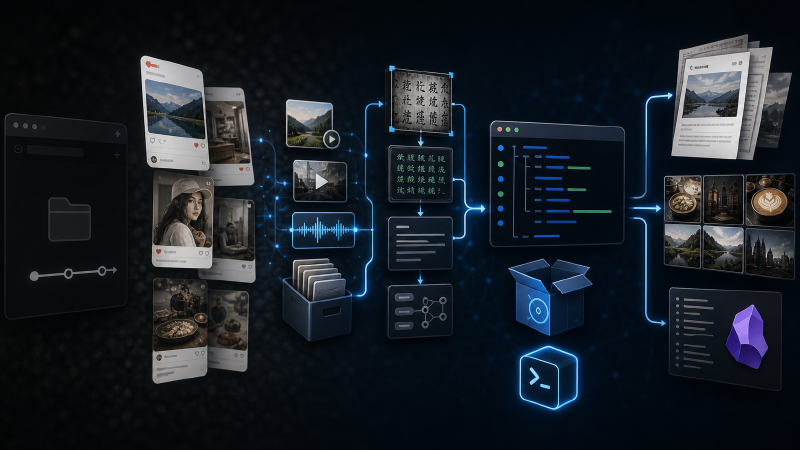
这篇是我的全过程复盘,不是摘要版。重点是把“从空仓到可发布版本”的真实路径写清楚。
我会尽量保留操作细节,包括:
- 我执行过的关键命令
- 我遇到的报错
- 我如何定位
- 我具体改了什么
- 我怎么复测
文中所有 Cookie / API Key 都是脱敏表达,不写明文。
0. 起点与约束
0.1 初始仓库状态
项目路径是:
F:\College\Activ_CodeProjects\PycharmProjects\XHSContentFetcher
我一开始先看目录:
| |
当时可见文件基本只有:
计划.mdLICENSEvenv/.idea/
也就是说,业务代码几乎是 0。
0.2 我给自己写死的目标,来自 计划.md
- 输入小红书分享链接,支持图文和视频。
- 抓取正文、评论、图片 / 视频。
- 图片 OCR。
- 视频关键帧抽取。
- 调 DeepSeek 生成可用于 Obsidian 的学习笔记。
- 全部做成 CLI,不做 GUI。
- 最终产物是“能直接进 Obsidian”的笔记和素材。
0.3 现实条件
- 我手里有一个参考仓库,但不确定有没有可复用代码。
- 我有图文和视频两条测试链接。
- 我有开发阶段所需 Cookie 和 DeepSeek Key,后续代码和文档全部脱敏。
1. 预研阶段:先确认抓取链路可行
我没有上来就写框架。我先做了 5 个预研动作。
1.1 动作一:确认项目现状
执行:
| |
结论:
- 仓库本体几乎没有业务代码。
- 这次必须从零搭。
1.2 动作二:完整读取计划
执行:
| |
结论:
- 技术目标很清楚:抓取 + OCR + 大模型 + Obsidian。
- 文风要求也清楚:去 AI 味、逻辑分点、自然表达。
1.3 动作三:核查参考仓库
执行:
| |
发现:
- 仓库只有
LICENSE,无可复用实现。
决策:
- 我不再依赖这个仓库,直接独立实现。
1.4 动作四:抓取库选型
执行:
| |
我后续做了 wheel 解包和源码检查,重点看:
xhs_cli/client.pyxhs_cli/client_mixins.pyxhs_cli/html_parser.pyxhs_cli/formatter.pyxhs_cli/cookies.py
我确认到的能力:
get_note_detailget_comments / get_sub_commentsget_note_from_html,用于 HTML 回退- 现成签名流程,我不用自己逆向签名
1.5 动作五:用真实 Cookie + 真实链接做最小验证
我写了临时脚本,直接调 XhsClient,分别验证图文和视频。
关键验证结果:
- 图文
note_card里有image_list、desc、interact_info。 - 视频
note_card.video.media.stream.h264能取到可下载流地址。 - 评论接口能正常返回。
到这里我才进入工程实现阶段。
2. 工程搭建阶段:从 0 到可执行 CLI
2.1 基础文件落地
我先建了最小工程骨架:
pyproject.toml.gitignoresrc/xhs_content_fetcher/__init__.pyREADME.md,初版
2.2 模块化拆分,第一版
我按职责拆成 12 个模块:
config.py:配置持久化 + Cookie 解析utils.py:通用工具函数url_parser.py:链接解析,包含重定向处理fetcher.py:详情 / 评论抓取 + 评论排序media.py:图片和视频下载video_tools.py:ffmpeg 调用、降采样、抽帧ocr_engine.py:PaddleOCR 封装deepseek.py:模型输入构造与调用markdown_writer.py:Markdown 产物写入obsidian.py:打开 Obsidianworkflow.py:端到端编排cli.py:命令入口
2.3 初始测试
我建了 3 个单测:
- URL 解析测试
- Cookie 解析测试
- 评论排序测试
执行:
| |
结果:
| |
3. 首轮端到端联调:先跑通图文 / 视频主链路
我先把变量收敛,避免 LLM 和 OCR 抢占排错注意力。
执行示意:
| |
3.1 第一个关键故障:API error: {"code": -1}
图文链路首次运行报错:
| |
3.2 我的定位路径
我没有直接改代码,而是先拆开验证:
get_note_detail单独调,成功。get_comments单独调,成功。- 失败集中在“抓子评论”阶段,部分
get_sub_comments偶发异常。
3.3 修复动作
我在 fetcher.py 里改 _fetch_sub_comments:
- 改成单条容错。
- 单条失败就跳过。
- 不让局部失败中断主流程。
修复后复测:
- 图文链路跑通。
- 视频链路跑通。
关键产物验证:
- 视频下载成功,文件是
video_raw.mp4。 - 关键帧抽取成功,默认抽取 8 帧。
- 评论抓取成功。
4. 媒体与 OCR 深度修复:这部分最耗时
4.1 图片输出成 .bin
现象:
- 图片文件变成
image_01.bin。 - Obsidian 预览和 OCR 都受到影响。
根因:
- 部分 CDN 响应缺失可靠
content-type。
修复:
我在 media.py 加了魔数检测和扩展名回退顺序:
- 先看内容头,覆盖 JPEG / PNG / GIF / BMP / WEBP / AVIF
- 再看
Content-Type - 再看 URL 后缀
- 最后才用
.bin
结果:
- 图片稳定输出为
.webp/.jpg/...。
4.2 OCR 初始化失败:缺底层依赖
现象:
| |
处理:
| |
4.3 PaddleOCR 参数兼容问题
我遇到两个典型兼容问题:
- 某些版本不接受
show_log。 - 新版在 OCR 参数里带
cls=True时会抛unexpected keyword。
修复策略:
- 初始化参数做多套回退。
- OCR 调用失败后回退到不带
cls的方式。
4.4 oneDNN / MKLDNN 兼容报错
现象:
| |
修复:
- 在
ocr_engine.py设置兼容环境变量,禁用问题路径。
4.5 中文路径导致 Invalid argument
现象:
- Paddle 在部分中文路径下读取文件失败。
修复:
- OCR 前先复制到临时 ASCII 路径。
- 识别完成后映射回原文件名。
4.6 OCR 文本污染
现象:
- OCR 结果混入临时路径字符串。
修复:
- 过滤
xhs_ocr_、盘符路径、tmp 路径行。
结果:
- OCR 文本可直接进入笔记。
4.7 OCR 超时不是功能失败
我实际还遇到过一次“超时中断”。
这次不是逻辑错误,而是首次全量 OCR 跑 8 张图时加载和推理时间偏长。
我采取的动作:
- 放宽命令超时窗口。
- 完整跑到底,再判断是否存在真实异常。
5. 提示词迭代:从“复述”改到“可读笔记”
链路跑通后,我回看产物,发现三个硬问题:
- 文本复述多,知识点拆解不够。
- 图片堆在文末,不是图文并茂。
- 口吻不像我的笔记。
5.1 第一次改造:强化提示词约束
我在 deepseek.py 做了三层调整:
- 固定第一人称口吻。
- 解释优先,要求按“是什么 / 为什么 / 怎么用 / 边界误区”拆解。
- 禁止教学腔、禁止空泛总结。
同时在 workflow.py 把素材相对路径直接喂模型:
assets/images/...assets/frames/...assets/video/...
目的很明确:模型必须内联引用,不允许文末堆图。
5.2 第二次改造:模板优先,禁用硬编码骨架
我后续把策略改成“模板优先”:
- 优先读取根目录
Tempate.md。 - 兼容
Template.md/template.md。 - 找不到模板就报错,不再自动生成章节骨架。
- 占位符替换真实路径:
assets.images[*].pathassets.video_frames[*].path
这一步的意义是:我把结构控制权从模型拿回到模板。
6. URL 解析事故:discovery/item/<id>
6.1 故障现象
新链接进入后,全链路失败:
| |
6.2 我的定位过程
我先用独立脚本验证,确认:
XhsClient.get_note_detail能拿到items。- 我自己的
url_parser把note_id解析错了,取成了item。
6.3 修复方案
我在 url_parser.py 做三点修复:
- 优先匹配 24 位 ID-like 片段。
- 特判
discovery/item/<id>。 - 保留
explore/<id>和item/<id>兼容逻辑。
复测结果:
| |
7. Obsidian 对接联调:命令可用,但编码有坑
7.1 CLI 可用性验证
执行:
| |
我确认:
- Obsidian CLI 可用。
- Vault 路径能识别到,例如
C:\Users\yourp\Documents\Obsidian Vault。
7.2 真机写入 + 自动打开
执行示意:
| |
结果:
- 笔记写入成功。
- 自动打开成功。
7.3 UnicodeDecodeError 修复
现象:
| |
根因:
subprocess捕获 Obsidian 输出时发生编码读流问题。
修复:
obsidian.py把stdout/stderr改成DEVNULL。
复测后恢复正常。
8. 我做过的回归验证清单
我不是“跑通一次就结束”,而是按层回归:
- 单测回归:
venv\Scripts\python -m pytest - 图文链路回归:
--skip-llm --skip-ocr - 视频链路回归:
--skip-llm --skip-ocr - OCR 层验证:单图 + 全量图
- DeepSeek 全链路验证:含模型调用产出
- 产物检查:笔记、图片、关键帧、视频、路径引用
期间我还做过环境检查:
| |
这样可以先排除本机 ffmpeg 工具链问题。
9. 文档、清理与发布
9.1 清理动作
我按交付要求清理:
output/tests/.pytest_cache/- 全部
__pycache__/
保留:
Tempate.md,后续生成结构依赖它
9.2 README 重写范围
我把 README 改成简体中文,覆盖:
- 功能全览
- 安装与依赖
- 配置方式
- 模板机制
- Obsidian 对接
- 常见问题排错
9.3 Git 提交和推送
我执行:
| |
结果:
- 提交:
13f8545 - 分支:
main - 远程推送成功
安全处理:
- 含敏感信息的
计划.md保持未跟踪,不进仓库。
10. 本次产出的最终代码结构
核心目录:
src/xhs_content_fetcher/cli.pysrc/xhs_content_fetcher/workflow.pysrc/xhs_content_fetcher/fetcher.pysrc/xhs_content_fetcher/media.pysrc/xhs_content_fetcher/video_tools.pysrc/xhs_content_fetcher/ocr_engine.pysrc/xhs_content_fetcher/deepseek.pysrc/xhs_content_fetcher/markdown_writer.pysrc/xhs_content_fetcher/obsidian.pysrc/xhs_content_fetcher/url_parser.pysrc/xhs_content_fetcher/config.pysrc/xhs_content_fetcher/utils.py
工程文件:
pyproject.toml.gitignoreREADME.mdTempate.md
11. 关键报错与修复对照
| 阶段 | 报错 / 问题 | 根因 | 修复 |
|---|---|---|---|
| 抓取 | API error: {"code": -1} | 子评论接口偶发失败 | 子评论单条容错,不阻断主流程 |
| 媒体 | 图片输出 .bin | CDN 响应类型不稳定 | 魔数识别 + 多级扩展名回退 |
| OCR | paddlepaddle not installed | 只装了 paddleocr | 补装 paddlepaddle |
| OCR | 参数不兼容 | PaddleOCR 版本差异 | 初始化 / 调用参数回退 |
| OCR | oneDNN 报错 | 后端兼容问题 | 兼容环境变量兜底 |
| OCR | Invalid argument | 中文路径读取问题 | 临时 ASCII 路径识别 |
| 解析 | note_id 被解析为 item | URL 规则覆盖不足 | 修复 discovery/item/<id> 解析 |
| Obsidian | UnicodeDecodeError | 子进程输出编码冲突 | stdout/stderr -> DEVNULL |
12. 命令流水节选
下面这组命令是我这次会话里反复执行的关键路径,按用途分组:
12.1 目录与文件检查
| |
12.2 抓取依赖验证
| |
12.3 本地构建与测试
| |
12.4 图文 / 视频端到端
| |
12.5 OCR 相关
| |
12.6 Obsidian 验证
| |
12.7 发布
| |
13. 我这次最值的三个决策
- 先做可用性验证,再做架构设计。
- 把长链路做成“局部失败不拖垮全流程”。
- 用模板约束生成结构,把质量控制权留在我手里。
14. 下一步优化计划
- 断点续跑,减少长任务重跑成本。
- OCR / LLM 缓存,按
note_id + 素材 hash。 - 结构化日志,覆盖阶段耗时和错误分类。
- 模板变量校验,缺失章节自动报错。
- “仅更新正文 / 仅更新评论”子命令。
- 多模型路由与失败回退策略。
15. 最终复盘一句话
这次我真正做成的,不是一个“能跑演示”的脚本,而是一条可定位、可修复、可复测、可发布、可复用的工程链路。